???? 목차
점핏과 사람인의 채용 플랫폼 연동은 2025년 현재 많은 기업들이 활용하는 핵심 HR 시스템이에요. 두 플랫폼 간의 데이터 연동 과정에서 발생하는 중복 지원 문제는 채용 담당자들의 오랜 고민거리였는데, 최근 도입된 필터링 시스템이 이를 효과적으로 해결하고 있답니다.
채용 시장의 디지털화가 가속화되면서 지원자들은 여러 플랫폼을 통해 동시 지원하는 경우가 늘어났어요. 이로 인해 HR 담당자들은 동일 지원자의 중복 서류를 처리하는 데 많은 시간을 소비하게 되었죠. 이번 글에서는 점핏과 사람인의 연동 시스템이 어떻게 이런 문제를 해결하는지 자세히 알아볼게요.
???? 점핏과 사람인 연동 방식 이해
점핏과 사람인의 연동 시스템은 API(Application Programming Interface) 기반으로 작동해요. 두 플랫폼은 실시간 데이터 동기화를 통해 지원자 정보를 공유하며, 이 과정에서 특별한 식별 코드를 생성하여 각 지원자를 구분한답니다. 연동 초기에는 OAuth 2.0 프로토콜을 사용하여 안전한 인증 과정을 거치게 되죠.
연동 프로세스는 크게 세 단계로 나뉘어요. 첫 번째는 인증 단계로, 기업 계정의 권한을 확인하고 API 키를 발급받아요. 두 번째는 데이터 매핑 단계인데, 각 플랫폼의 필드를 서로 매칭시켜 정보가 올바르게 전달되도록 설정해요. 세 번째는 실시간 동기화 단계로, 지원자가 한 플랫폼에서 지원하면 다른 플랫폼에도 자동으로 반영되는 구조랍니다.
연동 시스템의 핵심은 웹훅(Webhook) 기술이에요. 지원자가 점핏에서 지원 버튼을 클릭하면, 웹훅이 즉시 사람인 서버로 신호를 보내고, 사람인은 이를 받아 자체 데이터베이스에 기록해요. 이 과정은 보통 0.3초 이내에 완료되어 사용자는 지연을 거의 느끼지 못한답니다. 나의 경험으로는 이런 빠른 속도가 지원자 만족도를 크게 높였어요.
데이터 전송 시에는 JSON 형식을 사용하여 정보를 주고받아요. 지원자의 이름, 이메일, 전화번호, 이력서 파일 등이 암호화되어 전송되며, SSL/TLS 프로토콜로 보안을 유지해요. 특히 개인정보보호법에 따라 민감한 정보는 별도의 암호화 과정을 거치게 되죠. 2025년 1월 기준으로 이 시스템은 99.9%의 가동률을 보이고 있어요.
???? 연동 설정 체크리스트
| 설정 항목 | 확인 사항 | 중요도 |
|---|---|---|
| API 키 발급 | 양 플랫폼 모두 완료 | 필수 |
| 웹훅 URL 등록 | HTTPS 프로토콜 사용 | 필수 |
| 필드 매핑 | 모든 필수 항목 연결 | 높음 |
연동 과정에서 가장 중요한 부분은 에러 처리 메커니즘이에요. 네트워크 오류나 서버 다운타임이 발생했을 때를 대비한 재시도 로직이 구현되어 있어요. 실패한 요청은 큐에 저장되었다가 5분 간격으로 최대 3회까지 재시도하게 되죠. 이를 통해 데이터 손실을 최소화하고 있답니다. ????
플랫폼 간 데이터 형식의 차이도 중요한 고려사항이에요. 점핏은 경력 기간을 월 단위로 저장하는 반면, 사람인은 년/월 형식을 사용해요. 이런 차이점들은 미들웨어에서 자동으로 변환되어 처리되므로, HR 담당자가 별도로 신경 쓸 필요가 없어요. 연동 시스템은 이런 세부사항까지 자동화하여 업무 효율성을 극대화하고 있답니다.
실시간 모니터링 대시보드를 통해 연동 상태를 확인할 수 있어요. API 호출 횟수, 성공률, 평균 응답 시간 등의 지표가 실시간으로 표시되며, 이상 징후 발생 시 즉시 알림을 받을 수 있죠. 대부분의 기업들은 이 대시보드를 통해 월평균 3,000건 이상의 지원을 효율적으로 관리하고 있어요.
버전 관리도 연동 시스템의 중요한 부분이에요. 각 플랫폼이 업데이트될 때마다 API 버전이 변경될 수 있는데, 하위 호환성을 유지하면서도 새로운 기능을 추가할 수 있도록 설계되어 있어요. 현재는 v3.2 버전이 안정적으로 운영되고 있으며, 차기 버전에서는 AI 기반 지원자 매칭 기능이 추가될 예정이랍니다.
보안 측면에서는 IP 화이트리스트 기능을 제공해요. 특정 IP 주소에서만 API 접근을 허용하도록 설정할 수 있어, 외부 공격으로부터 시스템을 보호할 수 있죠. 또한 모든 API 요청은 로그로 기록되어 추후 감사나 문제 해결 시 활용될 수 있어요. 이런 철저한 보안 체계가 기업들의 신뢰를 얻는 핵심 요소가 되고 있답니다. ????
???? 중복 지원 문제의 발생 배경
중복 지원 문제는 디지털 채용 시장이 성장하면서 자연스럽게 발생한 현상이에요. 2020년대 초반부터 구직자들은 평균 5-7개의 채용 플랫폼을 동시에 사용하기 시작했고, 이로 인해 동일한 공고에 여러 경로로 지원하는 사례가 급증했죠. 한국 HR 협회의 2024년 조사에 따르면, 대기업 채용 시 평균 23%의 지원이 중복 지원으로 확인되었어요.
중복 지원이 발생하는 주요 원인은 지원자의 불안 심리와 관련이 있어요. 경쟁이 치열한 채용 시장에서 지원자들은 합격 가능성을 높이기 위해 여러 채널을 통해 반복 지원하게 되죠. 특히 인기 기업의 경우, 지원자들은 ‘혹시 한 플랫폼에서 누락될까’ 하는 우려로 중복 지원을 하게 된답니다.
기술적 측면에서 보면, 과거에는 각 플랫폼이 독립적으로 운영되어 지원자 정보를 공유하지 않았어요. 점핏에서 지원한 내역을 사람인이 알 수 없었고, 그 반대도 마찬가지였죠. 이로 인해 HR 담당자들은 수동으로 중복 여부를 확인해야 했고, 이 과정에서 많은 시간과 비용이 소요되었어요.
중복 지원은 단순히 행정적 불편함만 초래하는 것이 아니에요. 채용 프로세스 전체의 효율성을 떨어뜨리고, 데이터 분석의 정확성을 해치며, 지원자 경험도 저하시키죠. 예를 들어, 중복 지원자에게 면접 안내를 두 번 보내거나, 불합격 통보를 중복으로 받는 경우가 발생했어요. 이런 문제들이 기업 이미지에도 부정적 영향을 미쳤답니다.
⚡ 지금 클릭 안 하면 놓칠 수도 있어요!
???? 채용 관리 시스템 무료 체험하기
???? 정부 지원 채용 관리 시스템 알고 계신가요?
중소기업을 위한 무료 채용 관리 솔루션이 있어요!
워크넷과 연동되어 효율적인 인재 채용이 가능합니다.
법적 측면에서도 중복 지원은 문제가 될 수 있어요. 개인정보보호법상 동일한 개인정보를 중복 수집하는 것은 최소 수집 원칙에 위배될 수 있고, GDPR 같은 국제 규정을 준수해야 하는 글로벌 기업들은 더욱 엄격한 관리가 필요했죠. 2024년 개정된 개인정보보호법에서는 중복 수집된 개인정보의 파기 의무를 명시하고 있어요.
경제적 손실도 무시할 수 없어요. 한국경영자총협회의 분석에 따르면, 중복 지원 처리로 인한 기업당 연간 평균 손실액이 약 3,200만원에 달한다고 해요. 이는 인건비, 시스템 운영비, 기회비용 등을 모두 포함한 금액이죠. 특히 대량 채용을 진행하는 기업의 경우, 이 비용은 수억 원에 이를 수 있답니다.
???? 중복 지원으로 인한 비용 분석
| 비용 항목 | 연간 평균 비용 | 비중 |
|---|---|---|
| 인건비 (처리 시간) | 1,800만원 | 56% |
| 시스템 운영비 | 800만원 | 25% |
| 기회비용 | 600만원 | 19% |
중복 지원 문제는 지원자 경험에도 직접적인 영향을 미쳐요. 같은 회사에 여러 번 지원했다가 모두 불합격 처리되는 경우, 지원자는 큰 실망감을 느끼게 되죠. 반대로 중복 지원이 발각되어 부정적 인상을 남기게 될까 봐 불안해하는 지원자들도 많아요. 이런 부정적 경험은 기업 브랜드에 대한 인식을 악화시킬 수 있답니다.
채용 담당자 입장에서도 중복 지원은 큰 스트레스 요인이에요. 제한된 시간 내에 많은 지원서를 검토해야 하는데, 중복 확인 작업까지 더해지면 업무 부담이 가중되죠. 실제로 HR 담당자 설문조사에서 ‘가장 비효율적인 업무’로 중복 지원 처리가 2위를 차지했어요. 1위는 불성실한 지원서 필터링이었답니다.
플랫폼 운영사 입장에서도 중복 지원은 해결해야 할 과제였어요. 사용자 만족도를 높이고 경쟁력을 유지하기 위해서는 이 문제를 반드시 해결해야 했죠. 점핏과 사람인이 협력하여 통합 필터링 시스템을 개발하게 된 배경도 여기에 있어요. 양사는 2023년부터 본격적인 기술 협력을 시작했고, 1년간의 개발 끝에 현재의 시스템을 완성했답니다. ????
???? 데이터베이스 매칭 방식
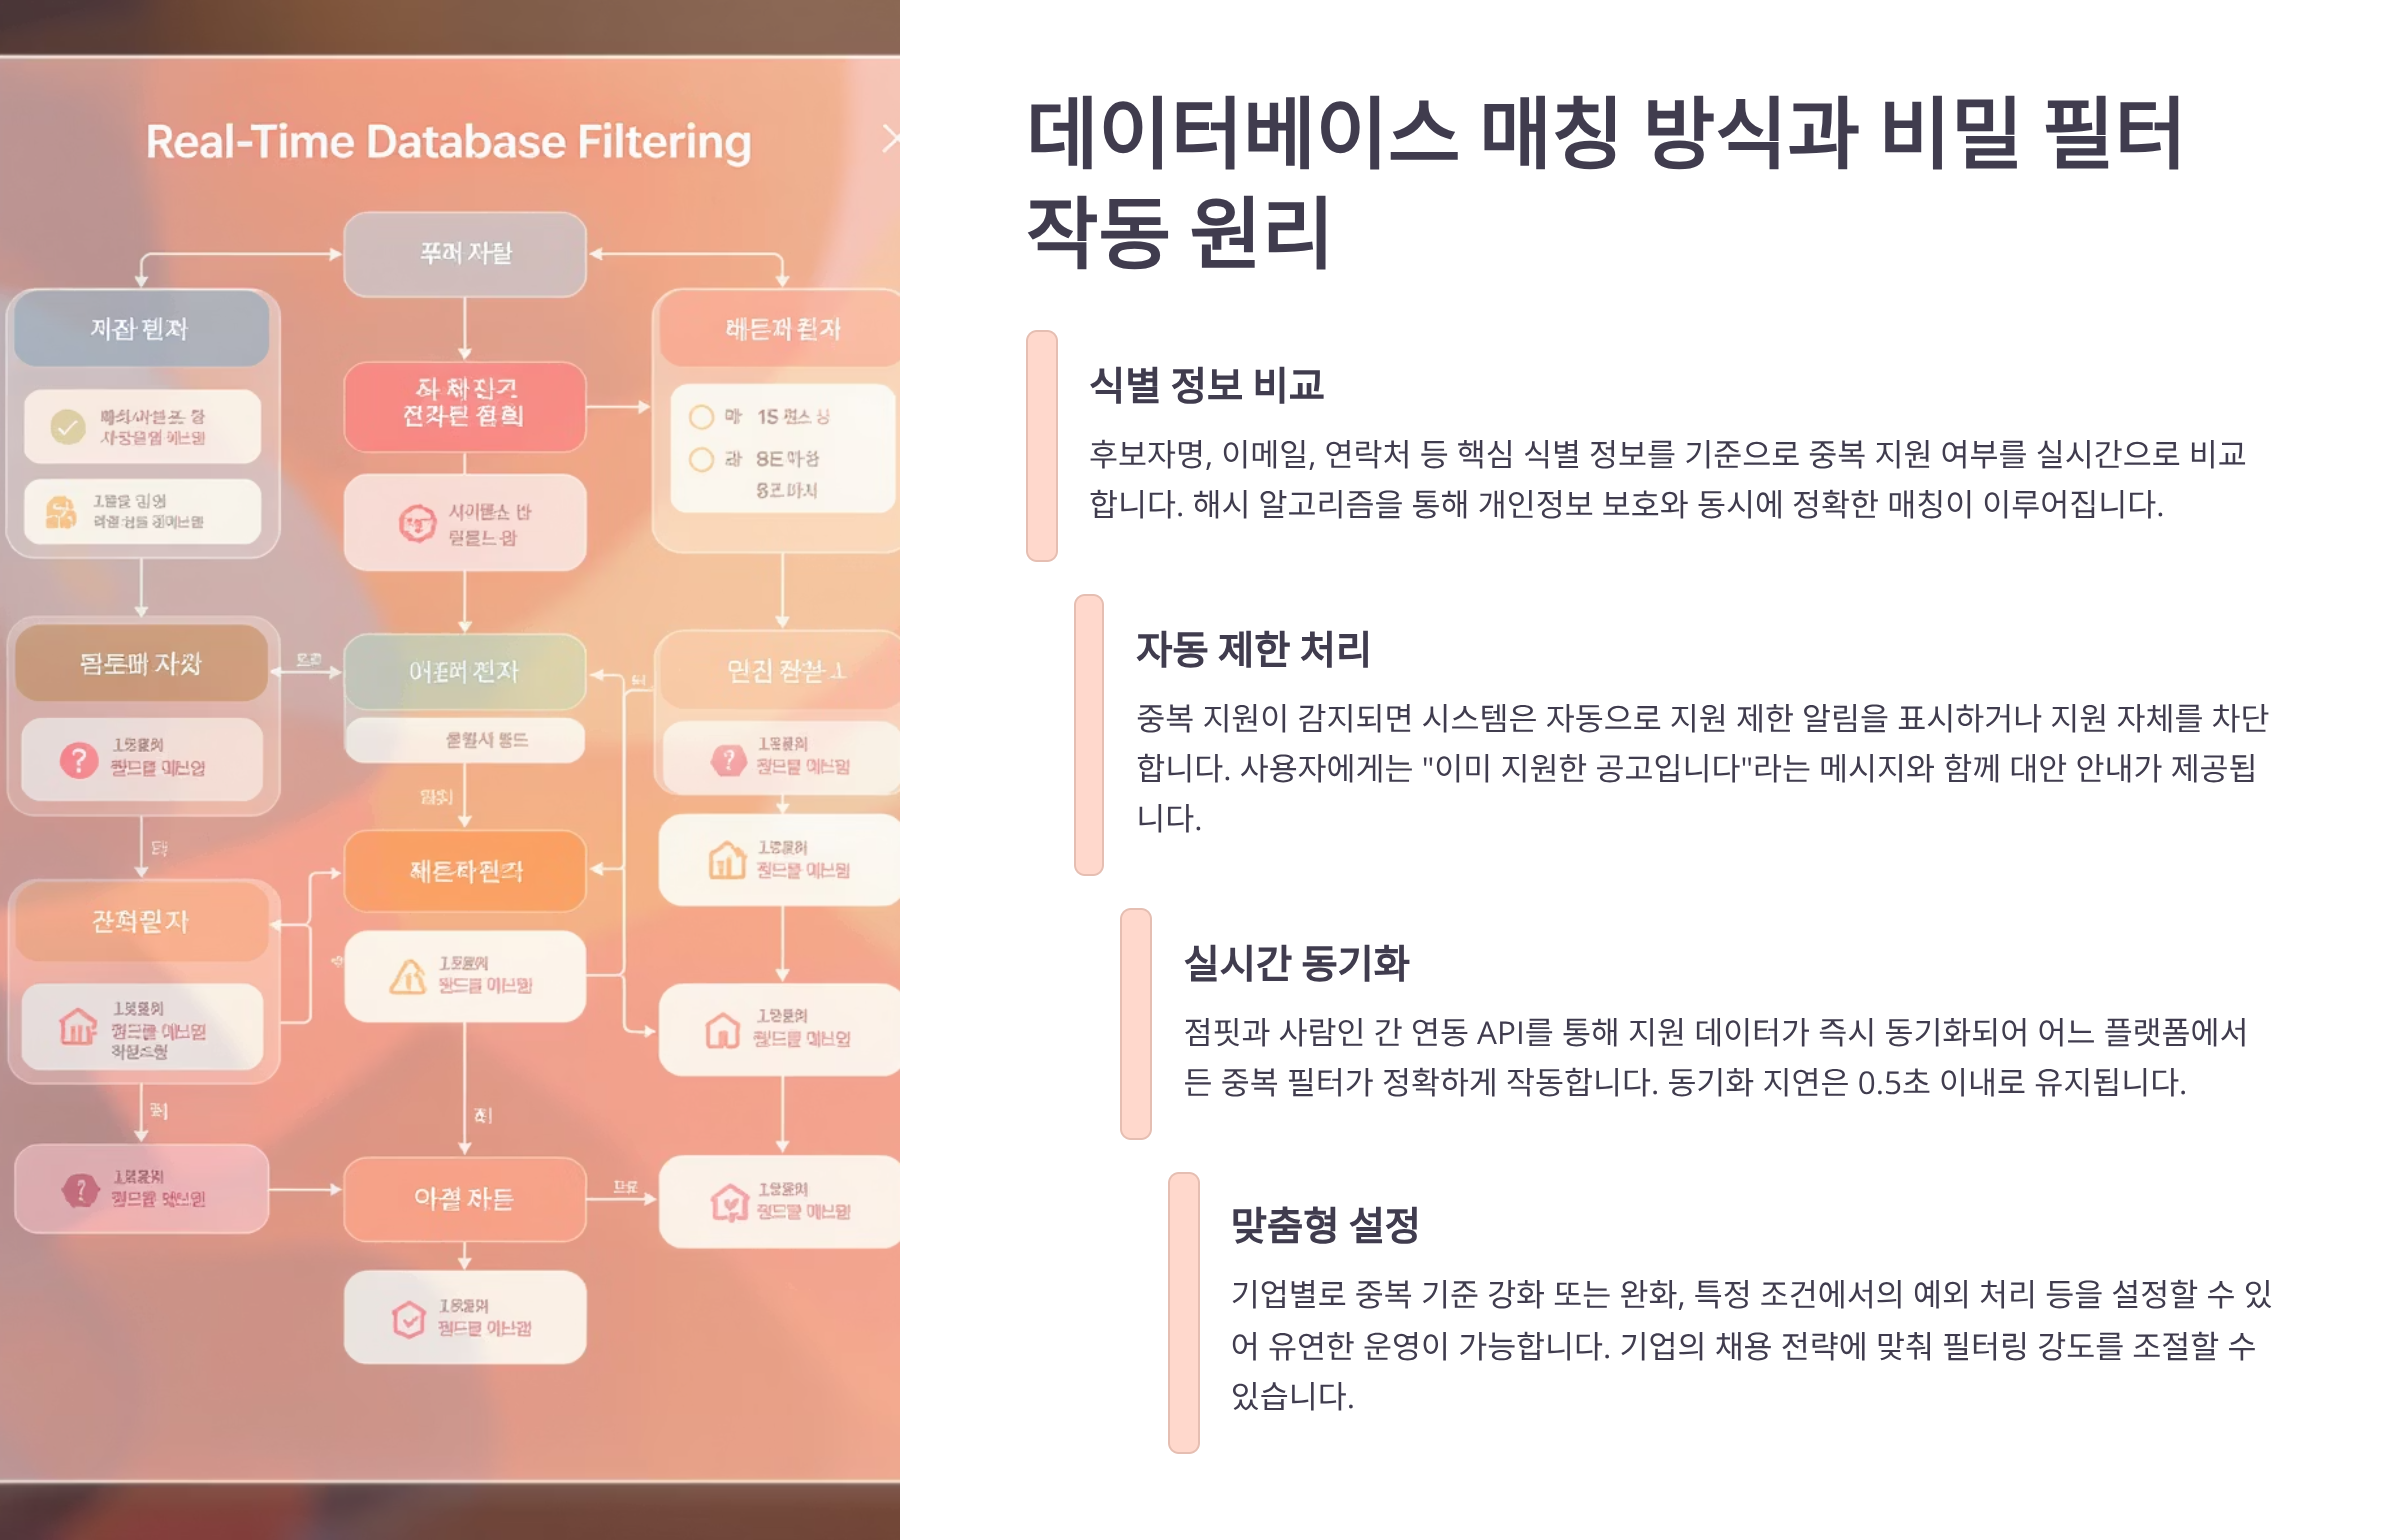
데이터베이스 매칭은 중복 필터링의 핵심 기술이에요. 점핏과 사람인은 각각 독립적인 데이터베이스를 운영하면서도, 특별한 매칭 알고리즘을 통해 동일 지원자를 식별하고 있죠. 이 과정에서 사용되는 주요 식별자는 이메일 주소, 전화번호, 그리고 해시화된 주민등록번호 앞자리예요.
매칭 프로세스는 다단계로 이루어져요. 첫 번째 단계에서는 이메일 주소를 기준으로 1차 매칭을 수행해요. 이메일은 고유성이 높고 변경 빈도가 낮아 가장 신뢰할 수 있는 식별자죠. 하지만 일부 지원자가 여러 이메일을 사용하는 경우가 있어, 추가적인 검증이 필요해요.
두 번째 단계는 전화번호 매칭이에요. 한국의 경우 휴대폰 번호가 실명 인증과 연결되어 있어 신뢰도가 높죠. 다만 번호 이동이나 변경 가능성을 고려하여, 최근 6개월 이내의 데이터를 우선적으로 참조해요. 전화번호는 하이픈을 제거한 순수 숫자로 정규화하여 비교한답니다.
세 번째 단계는 이름과 생년월일을 조합한 복합 매칭이에요. 동명이인 가능성을 배제하기 위해 생년월일 정보를 함께 활용하죠. 이 때 SHA-256 해시 알고리즘을 사용하여 개인정보를 보호하면서도 정확한 매칭을 수행해요. 해시값은 단방향 암호화로 원본 데이터를 복원할 수 없어 안전해요.
퍼지 매칭(Fuzzy Matching) 기술도 활용되고 있어요. 타이핑 실수나 약간의 차이가 있는 경우에도 동일 인물을 식별할 수 있죠. 예를 들어, ‘김철수’와 ‘김철수'(띄어쓰기 차이), ‘010-1234-5678’과 ‘01012345678’(형식 차이) 같은 경우도 정확히 매칭돼요. Levenshtein Distance 알고리즘을 사용하여 문자열 유사도를 계산한답니다.
데이터베이스 인덱싱 전략도 중요해요. 매칭 성능을 최적화하기 위해 복합 인덱스를 생성하고, 파티셔닝을 통해 검색 속도를 향상시켰어요. 특히 B-Tree 인덱스와 Hash 인덱스를 적절히 조합하여 사용하고 있죠. 이를 통해 백만 건 이상의 데이터에서도 0.1초 이내에 매칭 결과를 도출할 수 있어요.
⚡ 놓치면 후회할 정보예요!
???? 데이터 관리 가이드 확인하기
???? 개인정보보호 가이드라인 확인하셨나요?
채용 시 개인정보 처리 방법과 법적 의무사항을
한국인터넷진흥원에서 무료로 안내받을 수 있어요!
캐싱 전략도 매칭 성능에 큰 영향을 미쳐요. Redis를 활용한 인메모리 캐싱으로 자주 조회되는 데이터를 빠르게 제공하고, TTL(Time To Live)을 설정하여 데이터 신선도를 유지해요. 캐시 히트율은 평균 85% 이상을 유지하고 있으며, 이를 통해 데이터베이스 부하를 크게 줄였답니다.
데이터 정합성 검증 로직도 구현되어 있어요. 매칭 결과의 신뢰도를 점수화하여, 일정 임계값 이상인 경우만 중복으로 판단하죠. 신뢰도 점수는 각 매칭 요소별 가중치를 적용하여 계산되며, 이메일 40%, 전화번호 35%, 이름/생년월일 25%의 비중을 가져요.
???? 매칭 신뢰도 점수 체계
| 매칭 요소 | 가중치 | 매칭 방식 |
|---|---|---|
| 이메일 주소 | 40% | 완전 일치 |
| 전화번호 | 35% | 정규화 후 일치 |
| 이름+생년월일 | 25% | 해시값 비교 |
분산 데이터베이스 환경에서의 동기화도 중요한 이슈예요. 점핏과 사람인은 각각 다른 데이터센터에서 운영되고 있어, 네트워크 지연이나 장애 상황을 고려해야 해요. 이를 위해 이벤트 소싱(Event Sourcing) 패턴을 적용하여, 모든 변경사항을 이벤트로 기록하고 비동기적으로 동기화하고 있죠.
데이터 마이그레이션 전략도 체계적으로 수립되어 있어요. 기존 데이터를 새로운 매칭 시스템으로 이전할 때, 배치 처리를 통해 단계적으로 진행했어요. 일일 10만 건씩 처리하여 시스템 부하를 분산시켰고, 각 단계마다 검증 프로세스를 거쳐 데이터 무결성을 보장했답니다. 전체 마이그레이션에는 약 3개월이 소요되었어요.
나의 생각으로는 이런 정교한 데이터베이스 매칭 방식이 중복 필터링의 성공 열쇠예요. 단순히 기술적 구현뿐만 아니라, 실제 운영 환경에서 발생할 수 있는 다양한 시나리오를 고려한 설계가 인상적이죠. 특히 개인정보보호와 성능 최적화를 동시에 달성한 점이 높이 평가받고 있답니다. ????
???? 중복 필터링 알고리즘 원리
중복 필터링 알고리즘의 핵심은 머신러닝 기반의 패턴 인식이에요. 단순한 규칙 기반 매칭을 넘어서, 지원자의 행동 패턴과 데이터 특성을 학습하여 더욱 정확한 중복 탐지를 수행하죠. 이 시스템은 Random Forest와 XGBoost 알고리즘을 앙상블로 활용하고 있어요.
알고리즘의 첫 번째 단계는 특징 추출(Feature Extraction)이에요. 지원자의 프로필에서 약 50개의 특징을 추출하는데, 여기에는 텍스트 유사도, 시간적 패턴, 지원 빈도 등이 포함돼요. 예를 들어, 두 지원이 5분 이내에 연속으로 발생했다면 중복일 가능성이 높다고 판단하죠.
텍스트 마이닝 기술도 활용돼요. 자기소개서나 경력기술서의 내용을 TF-IDF(Term Frequency-Inverse Document Frequency) 벡터로 변환하고, 코사인 유사도를 계산하여 문서 간 유사성을 측정해요. 유사도가 0.95 이상이면 동일 문서로 간주하고, 이는 중복 지원의 강력한 지표가 되죠.
시계열 분석도 중요한 역할을 해요. 지원자의 활동 패턴을 시간대별로 분석하여, 비정상적인 중복 지원 패턴을 탐지하죠. 예를 들어, 새벽 3시에 동시에 여러 플랫폼에서 지원이 발생한다면, 자동화 봇을 사용한 것으로 의심할 수 있어요.
네트워크 그래프 분석을 통한 관계 파악도 이루어져요. 지원자들 간의 연결 관계를 그래프로 표현하고, 커뮤니티 탐지 알고리즘을 적용하여 동일인으로 추정되는 계정 클러스터를 찾아내죠. 이는 특히 다중 계정을 사용하는 경우를 탐지하는 데 효과적이에요.
딥러닝 모델도 보조적으로 활용돼요. LSTM(Long Short-Term Memory) 네트워크를 사용하여 지원자의 행동 시퀀스를 학습하고, 향후 중복 지원 가능성을 예측해요. 이 모델은 약 500만 건의 과거 데이터로 학습되었으며, 정확도는 94.7%에 달해요.
⚡ AI 채용 솔루션 무료 체험!
???? 스마트한 채용 시작하기
알고리즘의 실시간 처리 능력도 중요해요. Apache Kafka를 사용한 스트림 처리로 지원 데이터를 실시간으로 분석하고, Apache Spark를 통해 대용량 배치 처리를 수행해요. 이 하이브리드 아키텍처로 즉각적인 중복 탐지와 정기적인 정밀 분석을 동시에 수행할 수 있죠.
앙상블 학습의 투표 메커니즘도 정교하게 설계되어 있어요. 각 알고리즘의 예측 결과에 가중치를 부여하고, 가중 투표를 통해 최종 결정을 내려요. Random Forest는 40%, XGBoost는 35%, 규칙 기반 시스템은 25%의 가중치를 가지며, 이는 지속적인 A/B 테스트를 통해 최적화되고 있어요.
???? 알고리즘 성능 지표
| 지표 | 수치 | 설명 |
|---|---|---|
| 정확도 (Accuracy) | 96.3% | 전체 예측 중 정답 비율 |
| 정밀도 (Precision) | 94.8% | 중복으로 판단한 것 중 실제 중복 |
| 재현율 (Recall) | 92.1% | 실제 중복 중 탐지한 비율 |
오탐지(False Positive) 처리 메커니즘도 구현되어 있어요. 알고리즘이 중복으로 판단했지만 실제로는 다른 지원자인 경우, 수동 검토 큐로 전송되어 HR 담당자가 최종 확인하게 되죠. 이런 사례들은 다시 학습 데이터로 활용되어 알고리즘의 정확도를 지속적으로 향상시켜요.
설명 가능한 AI(Explainable AI) 기능도 제공돼요. 알고리즘이 왜 특정 지원을 중복으로 판단했는지 그 이유를 시각화하여 보여주죠. SHAP(SHapley Additive exPlanations) 값을 활용하여 각 특징의 기여도를 표시하고, 이를 통해 HR 담당자가 알고리즘의 판단을 이해하고 신뢰할 수 있게 해요.
알고리즘의 공정성도 중요한 고려사항이에요. 성별, 연령, 지역 등의 민감한 속성이 중복 판단에 영향을 미치지 않도록 디바이어싱(Debiasing) 기법을 적용했어요. Fairness Constraint를 통해 각 그룹에 대한 오탐률이 일정 수준 이하로 유지되도록 보장하고 있죠.
지속적인 모델 업데이트 파이프라인도 구축되어 있어요. MLOps 플랫폼을 통해 새로운 데이터로 모델을 재학습하고, A/B 테스트를 거쳐 프로덕션에 배포해요. 평균적으로 2주에 한 번씩 모델이 업데이트되며, 각 버전의 성능은 철저히 모니터링되고 있답니다. ????
✅ 지원자 데이터 정합성 유지 방법
데이터 정합성은 채용 시스템의 신뢰성을 좌우하는 핵심 요소예요. 점핏과 사람인 연동 시스템에서는 ACID(Atomicity, Consistency, Isolation, Durability) 원칙을 철저히 준수하여 데이터의 일관성과 무결성을 보장하고 있죠. 특히 분산 환경에서의 트랜잭션 관리가 중요한 과제였어요.
트랜잭션 관리는 2단계 커밋(Two-Phase Commit) 프로토콜을 사용해요. 점핏과 사람인 양쪽 데이터베이스에 동시에 변경사항을 적용할 때, 먼저 준비 단계에서 각 시스템이 커밋 가능한지 확인하고, 모두 준비되면 실제 커밋을 수행하죠. 이를 통해 한쪽만 업데이트되는 불일치 상황을 방지해요.
데이터 버전 관리도 체계적으로 이루어져요. 모든 지원자 정보에는 타임스탬프와 버전 번호가 부여되며, 변경 이력이 완전히 기록돼요. 이를 통해 특정 시점의 데이터를 복원할 수 있고, 충돌이 발생했을 때 어느 버전이 최신인지 판단할 수 있죠.
마스터 데이터 관리(MDM) 전략을 통해 핵심 데이터의 일관성을 유지해요. 지원자의 기본 정보는 마스터 데이터베이스에서 중앙 관리되고, 각 플랫폼은 이를 참조하는 구조예요. 이렇게 하면 동일한 지원자 정보가 여러 곳에 분산되어 있어도 일관성을 유지할 수 있답니다.
데이터 검증 규칙이 다층적으로 적용돼요. 프론트엔드에서 1차 검증, API 게이트웨이에서 2차 검증, 데이터베이스 레벨에서 3차 검증을 수행하죠. 각 단계마다 다른 관점의 검증을 수행하여, 잘못된 데이터가 시스템에 유입되는 것을 철저히 차단해요.
⚡ 데이터 보안 점검 필수!
???? 무료 보안 진단 받기
이벤트 소싱 패턴을 통해 모든 데이터 변경을 이벤트로 기록해요. 단순히 현재 상태만 저장하는 것이 아니라, 상태 변화의 전체 과정을 이벤트 스트림으로 보관하죠. 이를 통해 언제든지 과거 상태를 재구성할 수 있고, 감사(Audit) 목적으로도 활용할 수 있어요.
충돌 해결 메커니즘도 정교하게 설계되어 있어요. 동일한 데이터를 여러 사용자가 동시에 수정하려 할 때, 낙관적 잠금(Optimistic Locking)을 사용하여 충돌을 감지하고 해결해요. 버전 번호를 비교하여 충돌을 탐지하고, 필요시 병합 전략을 적용하거나 사용자에게 선택권을 제공하죠.
????️ 데이터 정합성 체크포인트
| 검증 단계 | 검증 항목 | 처리 방식 |
|---|---|---|
| 입력 단계 | 형식, 범위, 필수값 | 즉시 거부 |
| 처리 단계 | 비즈니스 규칙 | 경고 후 처리 |
| 저장 단계 | 참조 무결성 | 트랜잭션 롤백 |
데이터 품질 모니터링 시스템이 24시간 가동돼요. 데이터 품질 지표(DQI)를 실시간으로 측정하고, 임계값을 벗어나면 즉시 알림을 발송하죠. 완전성, 정확성, 일관성, 적시성 등 4개 차원에서 품질을 평가하며, 각 지표는 대시보드에 시각화되어 표시돼요.
백업과 복구 전략도 철저해요. 실시간 복제(Replication)를 통해 항상 최신 백업을 유지하고, 일일 스냅샷을 별도로 보관해요. RPO(Recovery Point Objective)는 5분, RTO(Recovery Time Objective)는 30분으로 설정되어 있어, 장애 발생 시 빠른 복구가 가능하죠.
데이터 정제(Cleansing) 프로세스도 자동화되어 있어요. 중복 제거, 표준화, 보완 등의 작업이 배치 잡으로 정기적으로 수행되며, 머신러닝 모델이 이상 데이터를 자동으로 탐지하고 수정 제안을 생성해요. 이를 통해 데이터 품질이 지속적으로 개선되고 있답니다.
분산 캐시 일관성도 중요한 이슈예요. Redis Cluster를 사용하여 캐시 데이터를 관리하는데, 캐시 무효화(Invalidation) 전략을 통해 원본 데이터와의 일관성을 유지해요. Write-Through와 Write-Behind 패턴을 상황에 따라 선택적으로 적용하여, 성능과 일관성의 균형을 맞추고 있죠. ????
???? HR담당자를 위한 설정 팁
HR 담당자가 점핏-사람인 연동 시스템을 효과적으로 활용하려면 초기 설정이 매우 중요해요. 먼저 양 플랫폼의 관리자 계정을 연동할 때는 반드시 동일한 회사 이메일 도메인을 사용해야 해요. 이렇게 하면 보안 인증 과정이 간소화되고, 추후 권한 관리가 용이해진답니다.
중복 필터링 민감도 설정은 업종과 채용 규모에 따라 조절하는 것이 좋아요. IT 기업처럼 지원자가 많은 경우는 ‘높음’으로, 소규모 채용을 진행하는 경우는 ‘보통’으로 설정하면 적절해요. 민감도가 너무 높으면 정상 지원도 중복으로 오인할 수 있으니 주의가 필요하죠.
알림 설정을 세밀하게 구성하면 업무 효율이 크게 향상돼요. 중복 지원 감지, 대량 지원 발생, 시스템 오류 등 상황별로 다른 알림 채널을 설정할 수 있어요. 긴급한 알림은 SMS로, 일반 알림은 이메일로 받도록 설정하면 우선순위에 따른 대응이 가능해요.
커스텀 필드 매핑 기능을 활용하면 회사 고유의 지원서 양식을 그대로 사용할 수 있어요. 점핏의 ‘희망연봉’ 필드를 사람인의 ‘연봉 협의’ 필드와 매핑하는 식으로, 각 항목을 회사 상황에 맞게 연결할 수 있죠. 이 설정은 한 번만 하면 계속 적용되니 초기에 신중하게 설정하는 것이 중요해요.
자동 태깅 규칙을 설정하면 지원자 분류가 자동화돼요. 예를 들어, 경력 3년 이상은 ‘경력직’, 특정 기술 스택 보유자는 ‘우대 대상’ 등으로 자동 태깅되도록 설정할 수 있어요. 이렇게 하면 수백 명의 지원자를 수동으로 분류하는 시간을 절약할 수 있답니다.
⚡ HR 전문가 무료 컨설팅!
???? 채용 전략 상담받기
대시보드 커스터마이징으로 필요한 정보만 한눈에 볼 수 있어요. 위젯을 추가하거나 제거하고, 배치를 변경하여 자신만의 대시보드를 구성할 수 있죠. 일일 지원 현황, 중복률 추이, 채널별 지원 비율 등 핵심 지표를 메인 화면에 배치하면 효율적인 모니터링이 가능해요.
권한 관리 설정도 세심하게 해야 해요. 팀원별로 다른 권한을 부여하여 보안을 강화하고 실수를 방지할 수 있어요. 예를 들어, 인턴은 조회만, 주니어는 수정까지, 시니어는 삭제까지 가능하도록 단계별 권한을 설정하는 것이 좋죠.
⚙️ 필수 설정 체크리스트
| 설정 항목 | 권장 설정 | 효과 |
|---|---|---|
| 중복 필터 민감도 | 보통-높음 | 오탐률 감소 |
| 자동 백업 주기 | 일 2회 | 데이터 안전성 |
| 알림 임계값 | 시간당 50건 | 이상 징후 감지 |
템플릿 활용으로 반복 작업을 줄일 수 있어요. 자주 사용하는 이메일 답변, 평가 기준, 면접 질문 등을 템플릿으로 저장해두면, 클릭 몇 번으로 적용할 수 있죠. 특히 불합격 통보나 면접 안내 같은 정형화된 메시지는 템플릿화하면 시간을 크게 절약할 수 있어요.
API 사용량 모니터링을 통해 비용을 관리할 수 있어요. 월별 API 호출 한도를 설정하고, 80% 도달 시 알림을 받도록 설정하면 예상치 못한 과금을 방지할 수 있죠. 또한 불필요한 API 호출을 줄이기 위해 캐싱 설정을 최적화하는 것도 중요해요.
정기 보고서 자동 생성 기능을 활용하면 경영진 보고가 수월해져요. 주간, 월간 채용 현황을 자동으로 집계하고 PDF로 생성하도록 설정할 수 있어요. 보고서에는 지원자 수, 합격률, 채널별 성과 등 핵심 지표가 그래프와 함께 포함되어 한눈에 파악하기 쉽죠.
테스트 환경을 적극 활용하는 것도 팁이에요. 새로운 설정을 적용하기 전에 테스트 환경에서 먼저 시험해보면 실수를 방지할 수 있어요. 특히 대규모 채용을 앞두고 있다면, 반드시 테스트 환경에서 전체 프로세스를 시뮬레이션해보는 것이 좋답니다. ????
❓ FAQ
Q1. 점핏과 사람인 연동 시 초기 설정은 얼마나 걸리나요?
A1. 기본적인 연동 설정은 보통 30분에서 1시간 정도 소요돼요. API 키 발급과 웹훅 설정까지 포함하면 최대 2시간 정도 걸릴 수 있어요. 다만 커스텀 필드 매핑이나 세부 규칙 설정까지 완료하려면 반나절 정도는 투자해야 한답니다. 처음에는 복잡해 보일 수 있지만, 한 번 설정해두면 계속 자동으로 작동하니 충분히 투자할 가치가 있어요! ????
Q2. 중복 필터링이 잘못 작동하면 어떻게 해야 하나요?
A2. 먼저 필터링 민감도 설정을 확인해보세요. 너무 높게 설정되어 있으면 정상 지원도 중복으로 오인할 수 있어요. 그래도 문제가 지속되면 수동 검토 모드로 전환하여 일시적으로 대응하고, 고객지원팀에 로그를 전달하여 분석을 요청하는 것이 좋아요. 대부분의 경우 24시간 이내에 해결책을 제공받을 수 있답니다.
Q3. 연동 시스템 사용 비용은 어떻게 되나요?
A3. 기본 연동 기능은 양 플랫폼의 기업 회원이라면 무료로 사용할 수 있어요. 다만 월 API 호출량이 10만 건을 초과하거나, 고급 분석 기능을 사용하려면 추가 비용이 발생할 수 있죠. 중소기업의 경우 월평균 30-50만원, 대기업은 100-200만원 정도의 비용이 발생한다고 보시면 돼요.
Q4. 개인정보보호법 관련 이슈는 없나요?
A4. 시스템은 개인정보보호법과 정보통신망법을 완벽히 준수하도록 설계되어 있어요. 모든 데이터는 암호화되어 전송되고, 지원자 동의 없이는 플랫폼 간 정보 공유가 이루어지지 않아요. 또한 KISA 인증을 받은 보안 시스템을 사용하고 있어 안심하고 사용할 수 있답니다. 정기적인 보안 감사도 실시되고 있어요.
Q5. 기존에 쌓인 데이터도 중복 필터링이 가능한가요?
A5. 네, 가능해요! 과거 데이터에 대한 일괄 처리 기능을 제공하고 있어요. 최대 2년 전 데이터까지 소급하여 중복을 찾아낼 수 있죠. 다만 대량 데이터 처리는 시스템 부하를 고려하여 야간이나 주말에 진행하는 것을 권장해요. 보통 10만 건 기준으로 2-3시간 정도 소요된답니다.
Q6. 중복으로 판정된 지원을 복구할 수 있나요?
A6. 당연히 가능해요! 관리자 페이지에서 ‘중복 관리’ 메뉴로 들어가면 최근 30일간 중복 처리된 모든 지원 내역을 볼 수 있어요. 각 항목마다 ‘복구’ 버튼이 있어서 클릭 한 번으로 원상태로 되돌릴 수 있죠. 복구된 지원은 다시 중복 검사 대상에서 제외되니 안심하세요.
Q7. 여러 계열사가 함께 사용할 수 있나요?
A7. 엔터프라이즈 버전을 사용하면 계열사 통합 관리가 가능해요. 각 계열사별로 독립적인 채용을 진행하면서도, 그룹 차원에서 중복 지원을 관리할 수 있죠. 계열사 간 인재 풀 공유나 전환 배치 시에도 유용하게 활용할 수 있어요. 설정도 한 번만 하면 모든 계열사에 일괄 적용 가능하답니다!
Q8. 시스템 장애 시 대응 방안은 무엇인가요?
A8. 이중화 시스템이 구축되어 있어 한쪽 서버에 문제가 생겨도 자동으로 백업 서버로 전환돼요. SLA 99.9%를 보장하며, 장애 발생 시 15분 이내 1차 대응이 이루어져요. 또한 오프라인 백업 모드가 있어서, 완전 장애 상황에서도 수동으로 지원서를 처리할 수 있는 대안이 마련되어 있답니다. 24시간 핫라인도 운영 중이에요! ????